


介绍
人工智能视频生成是一个过程,其中生成模型根据指令、参考或两者创建一个随时间变化的图像序列。输出不仅仅是一个书面描述转化为完成的电影。系统必须解释视觉概念,构建一个可信的图像,并在帧之间保持足够的连续性,以使结果看起来是有意图且可观看的。
对于讲故事的人来说,重要的问题不仅是工具看起来有多么令人印象深刻。重要的问题是它在工作流程中提供了什么帮助。它可以支持视觉探索、镜头开发、情绪测试、预可视化和选定片段的制作。它并不替代故事决策,例如观众应该注意什么、角色为何如此行动,或一个镜头如何改变下一个镜头的意义。
从提示到动态图像
大多数生成视频系统通过学习的视觉表示工作,而不是将每一帧视为无关的图片。提示提供条件设置:指导所需主题、动作、环境、相机行为、照明和风格的信息。视觉参考可以添加进一步的约束,例如角色的近似外观、位置的布局或前景与背景之间的颜色关系。
一个有用的高级模型是从不确定的视觉信息转向结构化序列。系统估计哪些图像可以满足条件,然后生成在空间和时间上相关的帧。确切的内部架构在工具之间有所不同,因此创作者应避免假设每个平台都暴露相同的控制或使用相同的术语。操作上重要的是结果:系统同时解决了图像问题和连续性问题。
文本有其局限性,因为语言不如故事板精确。短语“一个害怕的人在雨中街道上奔跑”留下了许多选择:这个人的方向、与相机的距离、速度、面部表情、街道布局,以及恐惧显现的时刻。一个更强的简报定义了视觉优先级,而不是添加装饰性语言。它说明了什么必须保持可识别,什么可以变化。
塑造镜头的视觉变量
在生成之前,将故事情节转化为可见的决策。识别主题、动作、场景、摄像机位置、运动、照明、色彩结构和情感重点。例如,“玛拉意识到火车已经离开”在表达为一个中景镜头时更有用,玛拉站在空荡荡的站台上,望向离开的火车,摄像机固定,冷清的晨光。情感的意义来自于情境和构图,而不仅仅是形容词“悲伤”。
构图控制注意力。靠近画框边缘的大脸与被负空间包围的小人物产生不同的解读。摄像机跟随奔跑的角色移动,传达的紧迫感与静态的广角镜头使角色显得孤立的效果截然不同。色彩也承载叙事信息:温暖的室内与蓝色的室外可以暗示安全和距离,而低对比度可能使某一时刻显得安静或不确定。
参考资料在其目的明确时最为有效。当身份或服装重要时使用角色参考,当空间设计重要时使用地点参考,当构图重要时使用构图参考。结合过多相互竞争的参考可能会使视觉目标模糊。在生成之前决定哪个参考优先,并检查输出是否尊重该优先级。
时间一致性与运动
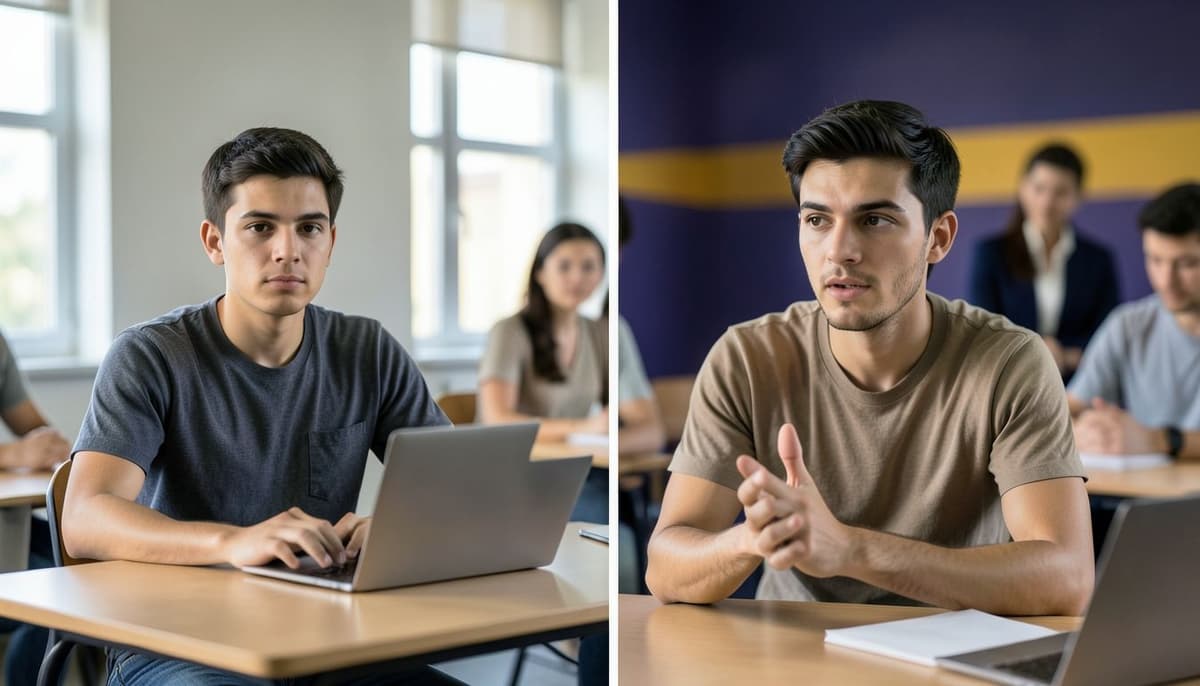
视频是通过时间来评判的,而不仅仅是吸引人的静态图像的集合。时间一致性意味着重要属性在每帧之间保持足够稳定:角色的身份、服装、身体结构、物体比例、光照方向和与环境的关系。一个结果在某一帧中看起来可信,但当面部形状变化、手多出手指或物体在运动中跳跃位置时可能会失败。
运动应被视为一种设计变化。定义什么在移动,什么保持静止,以及摄像机如何参与。在一个骑自行车者接近桥的镜头中,骑自行车者可以向前移动,车轮可以旋转,摄像机可以保持固定,而桥应保持其形状。如果提示暗示骑自行车者、摄像机、天气、背景和照明同时变化,系统需要维护更多关系,失败的风险增加。
从狭窄的运动简报开始。“一位女性缓慢地转头朝窗户看,而摄像机保持静止”比“一个电影中的女性戏剧性地反应,摄像机在更衣室中旋转”更容易评估。这并不意味着每个镜头都必须是静态的。这意味着运动应服务于可读的目的,并在序列可以支持的规模上引入。
人工智能在讲故事工作流程中的适用性
AI视频生成在探索过程中非常有用,因为它可以快速测试替代方案。导演可以在确定视觉方向之前比较特写镜头和广角镜头、温暖调色板和冷色调、慢速摄像机移动和固定镜头。它还可以创建临时的预可视化,帮助与合作者沟通节奏、布置和过渡。
一个实用的工作流程始于故事情节,而不是工具。用一句话写出情节,识别观众的预期焦点,并选择可以表达它的最简单镜头。生成一小组变体,检查它们的视觉和叙事功能,然后仅保留支持序列的版本。按顺序组装选定的镜头并判断过渡。一个单独看起来出色的片段,如果其屏幕方向、颜色、规模或情感强度与邻近镜头冲突,可能是错误的。
系统作为自主讲故事者的可靠性较低。它可能会发明道具、改变角色身份、忽视空间逻辑,或产生与预期动作不匹配的运动。人类的指导仍然是保持连续性、选择、节奏、伦理审查和最终意义的必要条件。将生成视为一个迭代的视觉制作阶段,而不是替代编辑判断。
评估和常见失败模式
用五个问题评估每个剪辑。意图的主题是否立即清晰?动作是否无需解释即可理解?身份或关键对象在镜头中是否保持稳定?相机运动是否改善了故事而不是分散注意力?剪辑是否与前后镜头建立了预期的关系?这些问题比仅仅询问输出是否看起来具有电影感更有用。
一个常见的失败是提示过载。添加许多风格、镜头、光照效果、动作和地点可能会导致矛盾的优先级。将简报缩减到基本的主题、动作、构图和情绪,然后在下一个迭代中添加一个可控变量。另一个失败是选择一个视觉上美丽但没有编辑目的的剪辑。在决定它是否属于最终序列之前,将其放置在周围的镜头旁边。
最后一个失败是将技术流畅性与叙事清晰性混淆。稳定的相机并不保证角色的动机是可见的,而一致的身份也不保证良好的节奏。标记观众应该理解变化的确切时刻。如果那个时刻不清晰,请修改构图、动作或镜头时长,而不仅仅是增加视觉细节。
总结
生成视频系统使用文本和视觉参考作为生成相关图像的条件。它们的实际挑战不仅仅是图像质量,而是主题身份、运动、构图和连续性的协调。创作者通过定义清晰的故事节拍和控制少量视觉变量来改善结果。
最强的工作流程将故事意图与镜头设计连接起来,选择性地使用参考,生成短小集中的变体,并按顺序评估剪辑。通过视觉证据和叙事功能来判断每个输出。人工智能可以加速探索和制作,但人类讲故事者仍然负责注意力、意义、连续性和最终选择。
课程检查点
巩固所学知识,获取作业反馈。