

再現可能な本番環境の症状から始める
本番環境のデバッグは、どの関数が壊れているかという推測ではなく、症状を正確に把握することから始まります。影響を受けているエンドポイント、HTTPメソッド、おおよその発生時刻、ステータスコード、レスポンスのレイテンシ、デプロイバージョン、そして問題が全ユーザーに影響しているのか、特定のセグメントだけに影響しているのかを記録します。たとえば、「リリース2025.03.18以降、ヨーロッパの顧客に対してPOST /api/ordersが500を返す」という情報は、「APIが不安定である」という説明よりはるかに有用です。
失敗するリクエストを、類似した入力を使用する成功リクエストと比較します。問題が常に発生するのか、断続的なのか、特定のリージョンに関連しているのか、あるいは特定のアカウント種別に限定されているのかを確認します。簡潔なインシデントのタイムラインを作成すると、症状と、デプロイ、データベース移行、環境変数の更新、トラフィック増加、サードパーティサービスの障害などの変更との関連を把握しやすくなります。この証拠により、アプリケーションコードを調査する前に検索範囲を絞り込めます。
Node.jsで構造化ログを使用する
複数の本番インスタンスが同時にリクエストを処理している場合、単純なコンソールメッセージは検索が困難です。timestamp、level、service、environment、requestId、route、statusCode、durationMs、エラー名などのフィールドを持つ構造化ログを使用します。PinoのようなロガーはJSONを効率的に出力できるため、ログプラットフォームでは文章を手作業で解析することなく、すべての500レスポンスを絞り込んだり、レイテンシ順にリクエストを並べ替えたりできます。
障害の説明に役立つコンテキストを含めますが、パスワード、アクセストークン、完全な決済情報、または制限のないリクエストボディをログに記録してはいけません。注文処理の失敗であれば、orderId、顧客セグメント、データベース操作名、依存サービスのステータスを記録するだけで十分な場合があります。ログレベルは一貫して使用します。重要なライフサイクルイベントにはinfo、復旧可能な異常にはwarn、調査が必要な障害にはerrorを使用します。スタックトレースは通常、正確なソース行と呼び出し経路を特定するため、内部ログには必ず元のエラースタックを含めてください。
サービスをまたいで1つのリクエストをトレースする
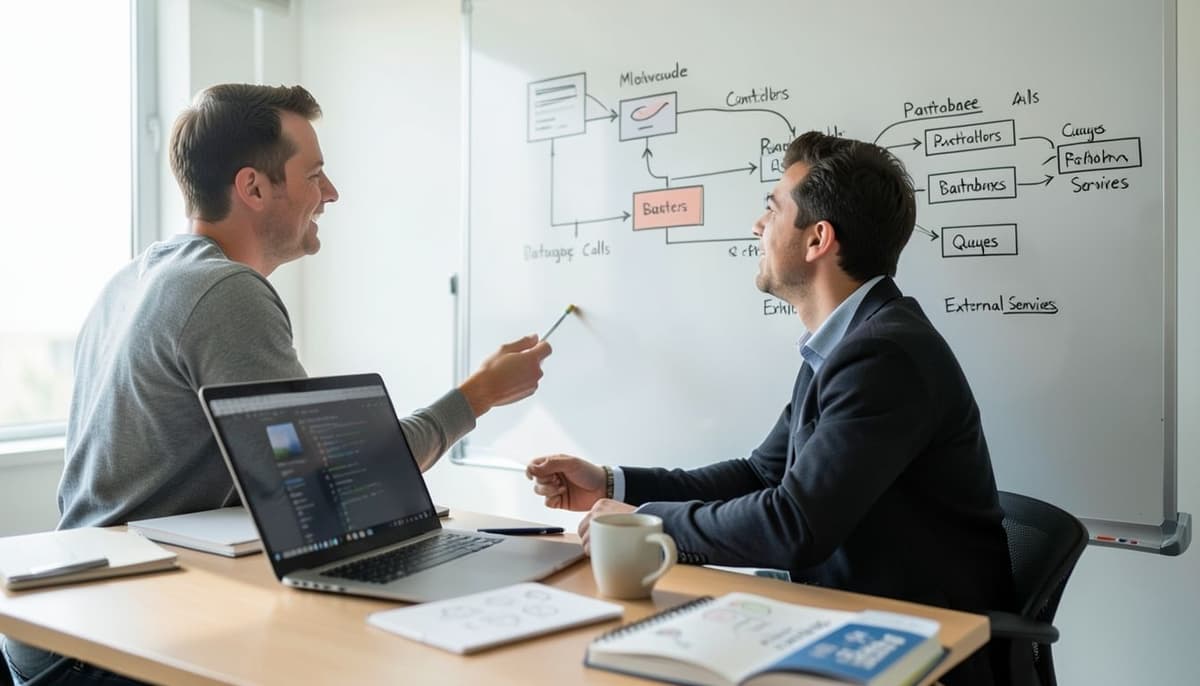
リクエストIDを使うと、1つの処理をミドルウェア、コントローラー、データベース呼び出し、キュー、外部サービスにまたがって追跡できます。クライアントからIDが提供されていない場合はエッジでIDを生成し、適切な場合にはレスポンスヘッダーに付加して、下流の呼び出しにも引き継ぎます。Expressアプリケーションでは、リクエストミドルウェアによって識別子をリクエストオブジェクトまたは非同期コンテキストに格納できるため、後続のログ出力でも同じ値を使用できます。
より広範なシステムでは、OpenTelemetryを使用した分散トレーシングを導入し、HTTPリクエストを通じてトレースコンテキストを伝播させます。トレースを確認すると、900ミリ秒のAPIレスポンスの内訳が、Node.jsで40ミリ秒、データベースクエリの待機に700ミリ秒、レコメンデーションサービスの呼び出しに160ミリ秒だったことが分かります。この内訳により、実際の遅延が依存先にあるにもかかわらず、アプリケーションチームがJavaScriptコードの最適化に注力してしまう事態を防げます。トレースは、プライバシー要件とコスト要件に従ってサンプリングおよびスクラブ処理されていることを確認してください。
サービスを停止させずにエラーを調査する
タグ :
- Web開発